

- Data Anda belum siap untuk AI bukan karena infrastruktur, tapi karena kesiapan data untuk AI, konsistensi, keterlacakan, kepercayaan belum dibangun.
- ERP dan sistem transaksional merekam “apa yang terjadi”, tapi jarang merekam “mengapa” keputusan itu diambil, padahal AI butuh keduanya.
- Data cleansing dan data warehouse membereskan kualitas data perusahaan, tapi tidak otomatis menciptakan konteks bisnis yang dibutuhkan AI.
- Perbaikan proses dan eksperimen AI bisa berjalan paralel, asal dimulai dari proses berisiko rendah dan bernilai tinggi, bukan volume terbesar.
- Sebelum percaya klaim vendor AI, wajib menguji cara sistem menangani data hilang, bias, dan tidak konsisten, bukan hanya melihat demo produk.
Data Anda belum siap untuk AI, dan penyebabnya, dalam banyak kasus, bukan infrastruktur.
Ketika proyek AI di perusahaan berhenti di tengah jalan, kecurigaan pertama biasanya jatuh ke infrastruktur: kapasitas cloud yang dianggap kurang besar, arsitektur data dianggap ketinggalan zaman, atau tim IT yang dianggap belum siap.
Survei nasional bahkan mencatat 81% perusahaan di Indonesia dinilai belum siap mengadopsi AI, dan infrastruktur selalu jadi alasan yang paling sering disebut.
Tapi begitu ditelisik lebih dalam, alasan itu sering kali baru gejala permukaan. Akar masalah yang lebih sering ditemukan justru lebih sederhana sekaligus lebih sulit diakui, yakni data yang lahir dari formulir kertas, input manual, dan spreadsheet.
Data semacam itu biasanya tidak konsisten dan tidak memiliki penanda waktu yang bisa dipercaya. Tanpa fondasi itu, otomatisasi tidak mempercepat keputusan yang benar, melainkan hanya mempercepat kesalahan yang sama untuk sampai ke lebih banyak orang lebih cepat.
Bagi Head of Analytics, Head of IT, Direktur Operasi, atau Head of Business Process yang sedang menyusun roadmap AI, pertanyaan yang lebih tepat adalah:
- bukan “berapa kapasitas server yang kita butuhkan?”
- melainkan “seberapa jauh kesiapan data untuk AI yang sudah kita bangun?”
Michael Sitorus, Lecturer, Auditor, dan Practitioner Digital Business di Cyber University, membedah persoalan ini dari sudut pandang yang jarang dibahas, yakni bukan dari sisi teknologi, tapi dari sisi apa yang sebenarnya hilang dari proses bisnis sehari-hari.
ERP Mencatat Hasil, Tapi Alasan di Baliknya Sering Hilang
Sistem ERP (Enterprise Resource Planning) dirancang untuk mencatat hasil transaksi dengan rapi: harga tertentu, tanggal tertentu, jumlah tertentu. Namun menurut Michael, kerapian itu menyimpan satu titik buta yang sering luput dari perhatian pimpinan.
ERP umumnya sangat baik dalam mencatat apa yang terjadi, tetapi tidak selalu mampu menjelaskan mengapa keputusan itu yang diambil.
Ambil contoh proses pembelian di sebuah UMKM atau perusahaan menengah. ERP bisa mencatat bahwa perusahaan membeli barang dari Vendor A dengan harga dan jumlah tertentu pada tanggal tertentu.
Tapi sistem tidak mencatat bahwa staf memilih Vendor A karena tahu Vendor B beberapa kali terlambat mengirim barang, atau karena ada pertimbangan kualitas, hubungan bisnis, urgensi proyek, dan kondisi pasar saat itu.
Maka hal yang hilang, menurut Michael, adalah konteks, pertimbangan, pengecualian, dan negosiasi langsung dengan user ketika keputusan itu diambil.
ERP menyimpan transaction trail, tetapi belum tentu decision trail. Untuk AI, keduanya sangat penting, AI tidak hanya membutuhkan hasil akhir, tetapi juga konteks yang menjelaskan hubungan antara kondisi, pertimbangan, keputusan, dan outcome.

Ini bukan sekadar catatan teknis. Bagi tim yang tengah menyiapkan data untuk model AI, perbedaan antara transaction trail dan decision trail menentukan apakah model nantinya bisa “mengerti konteks”, atau hanya menghafal pola tanpa alasan di baliknya.
Dashboard Bagus Bisa Menipu, Ini Tanda Data Belum Siapa AI
Tanpa asesmen formal pun, menurut Michael ada gejala sederhana yang bisa dilihat pimpinan dari mejanya sendiri, yakni:
- laporan dengan angka yang sama diminta dari dua divisi berbeda, tapi hasilnya tidak sama;
- tim masih harus melakukan koreksi manual di Excel sebelum data bisa dipakai;
- KPI (Key Performance Index)yang tidak konsisten antar periode;
- data historis yang berubah tanpa jejak perubahan yang jelas;
- kolom kosong yang bertebaran;
- kode pelanggan atau produk yang berbeda antar sistem;
- dan yang paling mendasar, tidak jelas siapa yang bertanggung jawab atas kualitas data tertentu.
Hal yang lebih menarik, kata Michael, adalah pertanda yang justru sering disalahartikan sebagai tanda kesiapan.
Dashboard yang bagus, data warehouse yang mentereng, cloud yang canggih, bahkan data dalam jumlah terabyte, semua itu belum otomatis berarti kualitas data perusahaan sudah siap dipakai untuk AI.
Readiness bukan dilihat dari seberapa banyak data yang dimiliki, tetapi dari seberapa dapat dipercaya data yang disajikan, konsistensi data dan informasi, kontekstual, terlacaknya data yang akurat, dan dapat digunakannya kembali data tersebut untuk pengambilan keputusan.
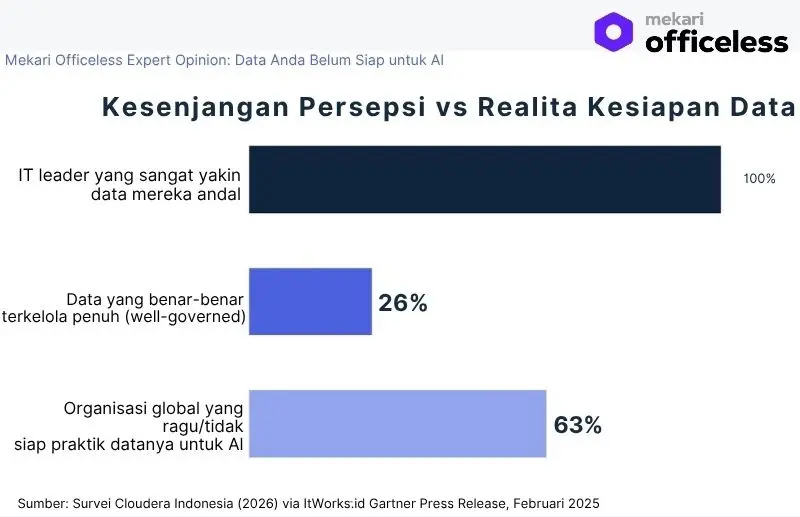
Pola ini bukan cerita satu perusahaan. Survei Cloudera terhadap organisasi di Indonesia mencatat seluruh (100%) IT leader yang disurvei menyatakan sangat atau cukup yakin dengan kualitas data organisasi mereka.
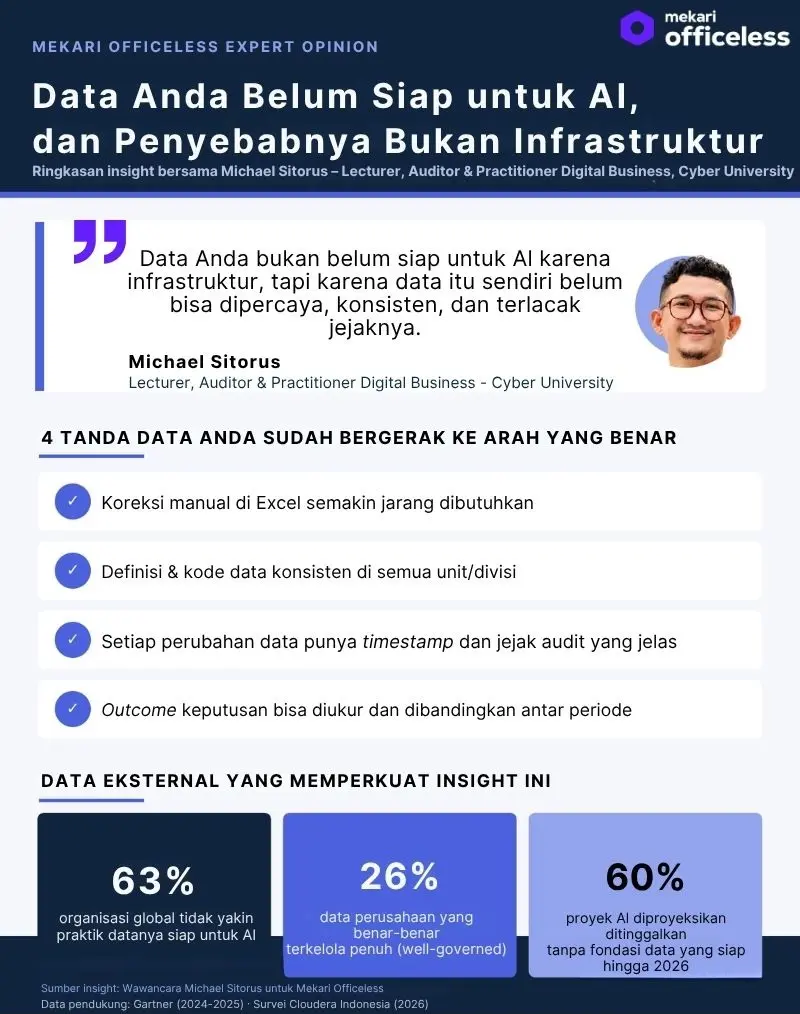
Namun hanya 26% yang mengakui datanya benar-benar terkelola penuh, dan 80% menyebut adopsi AI di perusahaan mereka masih terhambat oleh persoalan akses data.
Kesenjangan ini konsisten dengan temuan Gartner secara global: 63% organisasi menyatakan tidak memiliki, atau tidak yakin memiliki, praktik manajemen data yang layak untuk AI.
Artinya, kualitas data perusahaan sering dinilai bagus dari sisi tampilan, tapi belum tentu bagus dari sisi kesiapan data untuk AI yang sesungguhnya.
Kenapa Data Cleansing dan Data Warehouse Saja Tidak Cukup
Banyak perusahaan yang sudah menjalankan proyek data cleansing atau membangun data warehouse merasa persoalan datanya selesai.
Michael punya pandangan berbeda: proyek semacam itu menyelesaikan persoalan struktur dan kualitas data, tapi belum tentu menyelesaikan persoalan inti dan konteks proses bisnisnya.
Data duplikat dihapus, format tanggal diperbaiki, nama pelanggan disamakan, single source of truth dibangun, semua itu penting. Tapi data cleansing membersihkan apa yang salah dalam data, sementara data warehouse mengonsolidasikan data dari berbagai sumber.
Keduanya tidak otomatis menciptakan business context. Hal yang dibersihkan adalah data quality issue; yang tetap hilang adalah:
- decision context;
- process context;
- dan tacit knowledge.
Di sinilah data governance masuk sebagai lapisan yang berbeda dari sekadar cleansing.
Menurut definisi Gartner, data governance adalah kerangka strategis yang menetapkan hak keputusan (decision rights) dan akuntabilitas untuk memastikan kualitas, keamanan, serta keselarasan data dengan tujuan bisnis.
Artinya, data governance bukan proyek satu kali yang selesai begitu data warehouse jadi, melainkan mekanisme berkelanjutan yang menjawab pertanyaan lebih mendasar:
- siapa yang berwenang atas data ini?
- mengapa keputusan yang direkam di dalamnya diambil seperti itu?
Butuh lapisan yang menangkap decision context ini?
Mekari Officeless membantu perusahaan menambahkan workflow, approval, dan dokumentasi keputusan di atas ERP yang sudah berjalan, sehingga proses bisnis merekam bukan cuma hasil akhirnya, tapi juga alasan dan jejak audit di baliknya.
Lihat solusi Mekari Officeless di Sini!
Menentukan Prioritas Pembenahan: Bukan Volume, Tapi Value per Data
Jika perusahaan hanya bisa membenahi satu atau dua proses lebih dulu, kriteria apa yang dipakai?
Michael menegaskan, volume data terbesar tidak otomatis menjadi prioritas terbaik, itu hanya alat bantu ketika dua pilihan sama-sama kuat, bukan alasan untuk menggugurkan pilihan lain.
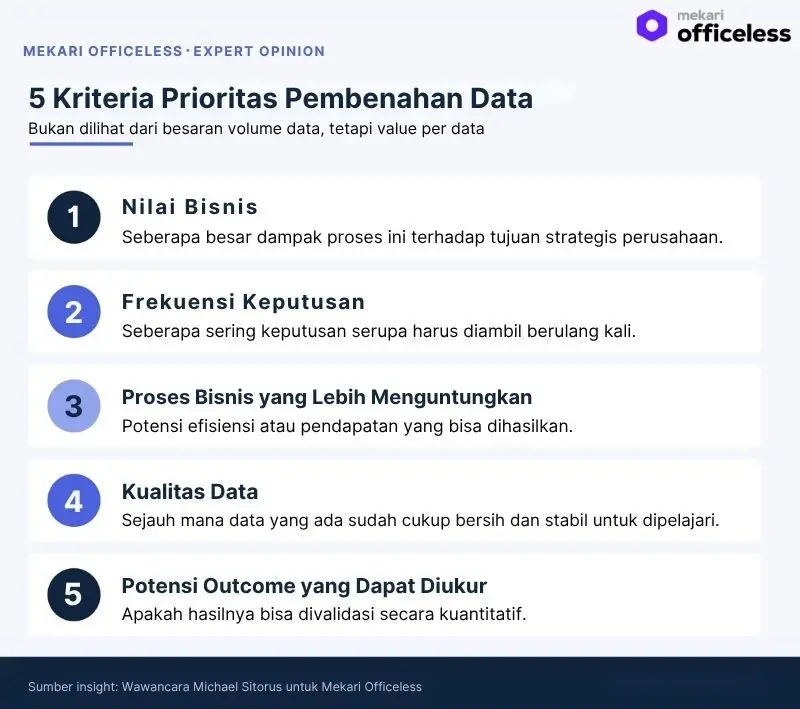
Setidaknya ada lima kriteria yang ia pakai:
- Nilai bisnis: seberapa besar dampak proses ini terhadap tujuan strategis perusahaan.
- Frekuensi keputusan: seberapa sering keputusan serupa harus diambil berulang kali.
- Proses bisnis yang lebih menguntungkan: potensi efisiensi atau pendapatan yang bisa dihasilkan.
- Kualitas data: sejauh mana data yang ada sudah cukup bersih dan stabil untuk dipelajari.
- Potensi outcome yang dapat diukur: apakah hasilnya bisa divalidasi secara kuantitatif.
Proses dengan skala nilai besar belum tentu jadi prioritas utama kalau datanya buruk atau prosesnya sendiri tidak stabil.
Sebaliknya, proses dengan skala nilai lebih kecil tapi punya keputusan berulang, outcome jelas, dan dampak bisnis tinggi, justru bisa jadi kandidat AI yang jauh lebih matang.
Contoh yang diberikan Michael adalah customer service: volumenya mungkin tidak sebesar transaksi penjualan, tapi kalau perusahaan punya data pertanyaan pelanggan, respons petugas, waktu penyelesaian, dan tingkat kepuasan, itu justru bahan yang lebih siap untuk AI learning.
Kriteria prioritas, katanya, bukan dilihat dari besaran volume data, tetapi value per data.
Memperbaiki Proses dan Menjajal AI Bisa Berjalan Bersamaan
Apakah temuan-temuan di atas berarti perusahaan harus menunda AI sampai seluruh prosesnya rapi?
Michael menjawab tegas: tidak. Ia tidak menyarankan perusahaan menunggu seluruh proses sempurna dulu sebelum mulai memakai AI.
Pendekatan yang lebih realistis adalah menjalankan process improvement dan eksperimen AI secara paralel, dengan syarat eksperimen ditempatkan pada area berisiko terkendali, misalnya pencarian dokumen internal, klasifikasi dokumen, analisis pola keluhan, atau decision support.
AI, dalam pandangannya, justru bisa diperlakukan sebagai sarana untuk menemukan kelemahan data.
Ketika model gagal karena informasi tidak lengkap atau definisi data tidak konsisten, kegagalan itu menjadi masukan untuk memperbaiki proses. Prinsipnya sederhana: improve while experimenting.
Untuk perusahaan yang baru mendigitalkan prosesnya dalam beberapa bulan terakhir, Michael tidak menganggap durasi sebagai ukuran kesiapan.
Proses yang menghasilkan ribuan observasi dengan struktur konsisten dalam beberapa bulan bisa memberi insight lebih baik daripada proses yang berjalan bertahun-tahun tapi pencatatannya tidak konsisten.
Hal yang lebih penting adalah menetapkan definisi data, mandatory field, timestamp, identitas pengguna, status proses, alasan perubahan, dan outcome bisnis sejak sekarang. Karena itulah cara membangun historical asset untuk masa depan.
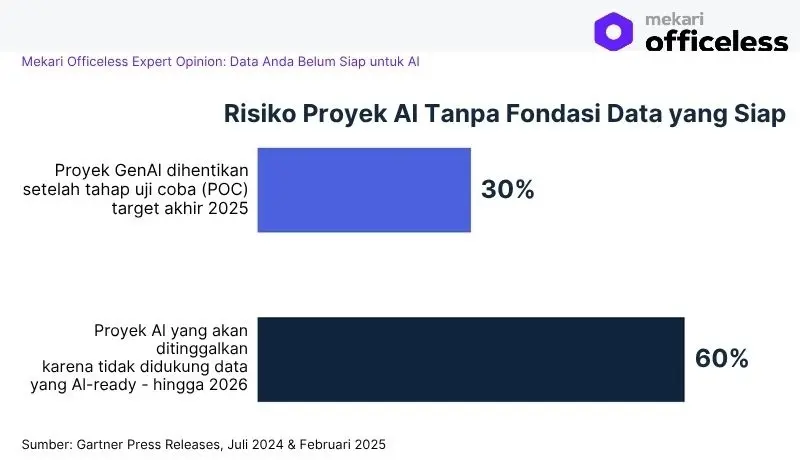
Urgensi memulai dari sekarang ini didukung data Gartner: setidaknya 30% proyek generative AI diperkirakan dihentikan setelah tahap proof of concept pada akhir 2025, dan hingga 2026 sebanyak 60% proyek AI yang tidak didukung data yang AI-ready diproyeksikan akan ditinggalkan.
Dari sisi biaya, Gartner juga mencatat rata-rata perusahaan menanggung kerugian sekira US$12,9 juta per tahun akibat kualitas data yang buruk, jauh lebih besar dari biaya membangun fondasi data sejak awal.
Waspada, AI Bisa Belajar dari Kebiasaan Buruk
Proses yang tercatat dalam sistem sering kali merekam bagaimana orang menyiasati sistem, bukan bagaimana prosedur seharusnya berjalan.
Hal ini, menurut Michael, salah satu risiko terbesar penerapan AI: jika penyimpangan yang dilakukan pengguna dianggap sebagai ground truth, AI berpotensi mempelajari perilaku yang salah, alih-alih prosedur yang benar.
AI bukan memperbaiki proses, tetapi justru mengotomatisasi kebiasaan buruk.
Karena itu, perusahaan perlu membedakan antara observed behavior dan desired behavior.
Michael membagi pola yang terekam menjadi tiga kategori:
- pola yang sesuai SOP dan menghasilkan outcome baik;
- penyimpangan yang ternyata terjadi karena SOP-nya sendiri tidak realistis;
- dan penyimpangan yang memang murni kesalahan atau workaround.
Kategori kedua paling menarik untuk diperhatikan, karena menunjukkan masalahnya mungkin bukan pada pengguna, melainkan pada desain proses itu sendiri.
AI tidak bisa memfilter ini secara otomatis, sifatnya memang merekam semua yang dijalankan pengguna.
Karena itu, hasil rekaman pola dari sistem perlu diberi konteks tambahan: apakah suatu perilaku merupakan best practice, exception, workaround, atau error.
Batas antara Insting Berpengalaman dan yang Bisa Direkam Sistem
Sebagian keputusan operasional terbaik lahir dari pertimbangan staf berpengalaman yang tidak pernah tertulis di mana pun.
Michael realistis soal ini: sebagian penalaran semacam itu bisa ditangkap sistem lewat dokumentasi keputusan, histori data, decision log, wawancara dengan subject matter expert, knowledge base, dan histori kasus. Tapi tidak semua intuisi bisa dipindahkan menjadi aturan atau dataset.
Contoh yang ia berikan: seorang sales berpengalaman bisa membaca perubahan perilaku pelanggan dari percakapan singkat dan memahami bahwa pelanggan kemungkinan besar akan berpindah ke kompetitor. Sebagian sinyal itu bisa didokumentasikan, tapi sebagian lainnya berasal dari pengalaman, intuisi, dan konteks sosial yang sangat sulit diformalkan.
Karena itu, tujuan AI bukan selalu menggantikan manusia, tetapi mengubah sebagian tacit knowledge menjadi institutional knowledge dan menyediakan decision support bagi pengguna.
Cara Menguji Klaim Vendor AI Sebelum Menandatangani Kontrak
Ketika vendor menawarkan solusi AI dan mengklaim bisa bekerja dengan data perusahaan apa adanya, Michael menyarankan pimpinan meminta vendor menunjukkan data seperti apa yang sebenarnya dibutuhkan model, bukan hanya demonstrasi produk.
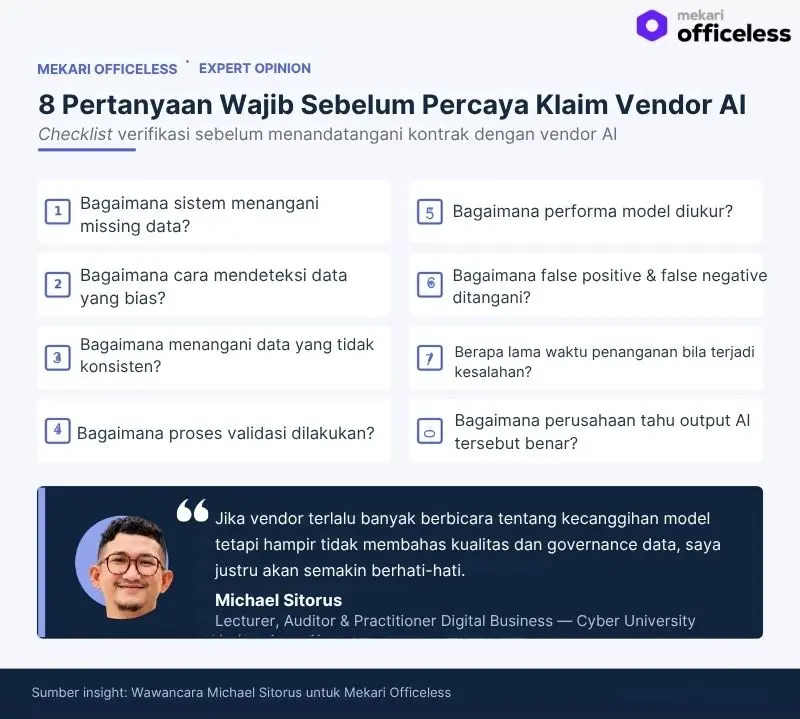
Beberapa pertanyaan verifikasi yang sebaiknya diajukan:
- Bagaimana sistem menangani missing data?
- Bagaimana cara mendeteksi data yang bias?
- Bagaimana menangani data yang tidak konsisten?
- Bagaimana proses validasi dilakukan?
- Bagaimana performa model diukur?
- Bagaimana false positive dan false negative ditangani?
- Berapa lama waktu penanganan bila terjadi kesalahan?
- Bagaimana perusahaan bisa tahu bahwa output AI tersebut benar?
Jika vendor terlalu banyak berbicara tentang kecanggihan model tetapi hampir tidak membahas kualitas dan governance data, saya justru akan semakin berhati-hati.
Klaim yang menurutnya patut dicurigai adalah AI yang katanya bisa memakai data apa adanya tanpa persiapan sama sekali, cukup diunggah lalu langsung memberi keputusan akurat.
Dalam praktiknya, AI yang baik bukan cuma soal model, ia harus melingkupi data preparation, data governance, data validation, data monitoring, data security, data privacy, human oversight, dan continuous improvement.
Tanda-Tanda Perusahaan Sudah Bergerak ke Arah yang Benar
Selama perbaikan proses berjalan dan sebelum satu pun model AI diterapkan, manajemen tetap butuh indikator kemajuan.
Michael menyebut beberapa yang bisa dipantau:
- koreksi manual yang makin sedikit
- definisi data yang makin konsisten antar unit
- jumlah data hilang yang makin rendah
- setiap perubahan yang punya timestamp
- jejak audit lengkap dengan alasan keputusan dan identitas pelaku
- outcome keputusan yang bisa diukur dan makin comparable dari satu periode ke periode berikutnya
- serta pertanyaan bisnis yang makin mudah dijawab tanpa rekonstruksi data manual
Kalau indikator-indikator ini mulai terlihat, kata Michael, di situlah manajemen mulai bisa menjawab lima pertanyaan dasar: apa yang terjadi, kapan terjadi, siapa yang melakukan, mengapa keputusan diambil, dan apa hasilnya.
Justru di titik itulah, bukan di kecanggihan teknologi AI-nya, kesiapan data untuk AI yang sesungguhnya dimulai.
Kesimpulan: Kesiapan Data untuk AI, Titik Awal yang Sesungguhnya, Bukan Infrastruktur
Data Anda belum siap untuk AI, satu benang merah terus menegaskan bahwa penyebabnya memang bukan infrastruktur.
Kesiapan AI bukan soal seberapa besar data yang dimiliki perusahaan, atau seberapa canggih dashboard dan cloud yang dipakai.
Kesiapan AI ditentukan oleh seberapa bisa dipercaya, konsisten, dan terlacaknya data yang menopang keputusan sehari-hari.
Data yang lahir dari formulir kertas dan spreadsheet, tanpa penanda waktu dan konteks yang jelas, akan membuat otomatisasi hanya mempercepat kesalahan yang sama.
Bagi Head of Analytics, Head of IT, Direktur Operasi, dan Head of Business Process, pekerjaan rumah yang paling mendesak bukan menunggu infrastruktur sempurna, melainkan membangun disiplin pencatatan: definisi data yang jelas, mandatory field, timestamp, identitas pengguna, alasan perubahan, dan outcome bisnis.
Fondasi itulah yang membedakan perusahaan yang benar-benar siap memanfaatkan AI dari yang baru siap mendemonstrasikannya.
Data Anda sudah siap dianalisis, tapi belum siap untuk AI?
ERP Anda mencatat transaksinya, tapi belum tentu merekam decision trail, workflow persetujuan, dan jejak audit yang dibutuhkan AI untuk benar-benar bisa dipercaya.
Mekari Officeless memperluas ERP yang sudah Anda pakai saat ini dengan workflow, dokumentasi keputusan, dan audit trail yang konsisten, tanpa migrasi, tanpa mengganti sistem inti.
Jadwalkan Konsultasi Gratis dengan Mekari Officeless!
Pelajari lebih lanjut: officeless.mekari.com
Referensi
Gartner (Feb 2025). “Lack of AI-Ready Data Puts AI Projects at Risk”
Gartner (Jul 2024). “Gartner Predicts 30% of Generate AI Projects Will Be Abandoned After Proof of Concept By End of 2025”
Gartner. “Riset 2020”
Cloudera. “Data Readiness Index”
IMCNEWS. “Hasil Survei, 81 Persen Perusahaan di Indonesia Belum Siap Adopsi AI”